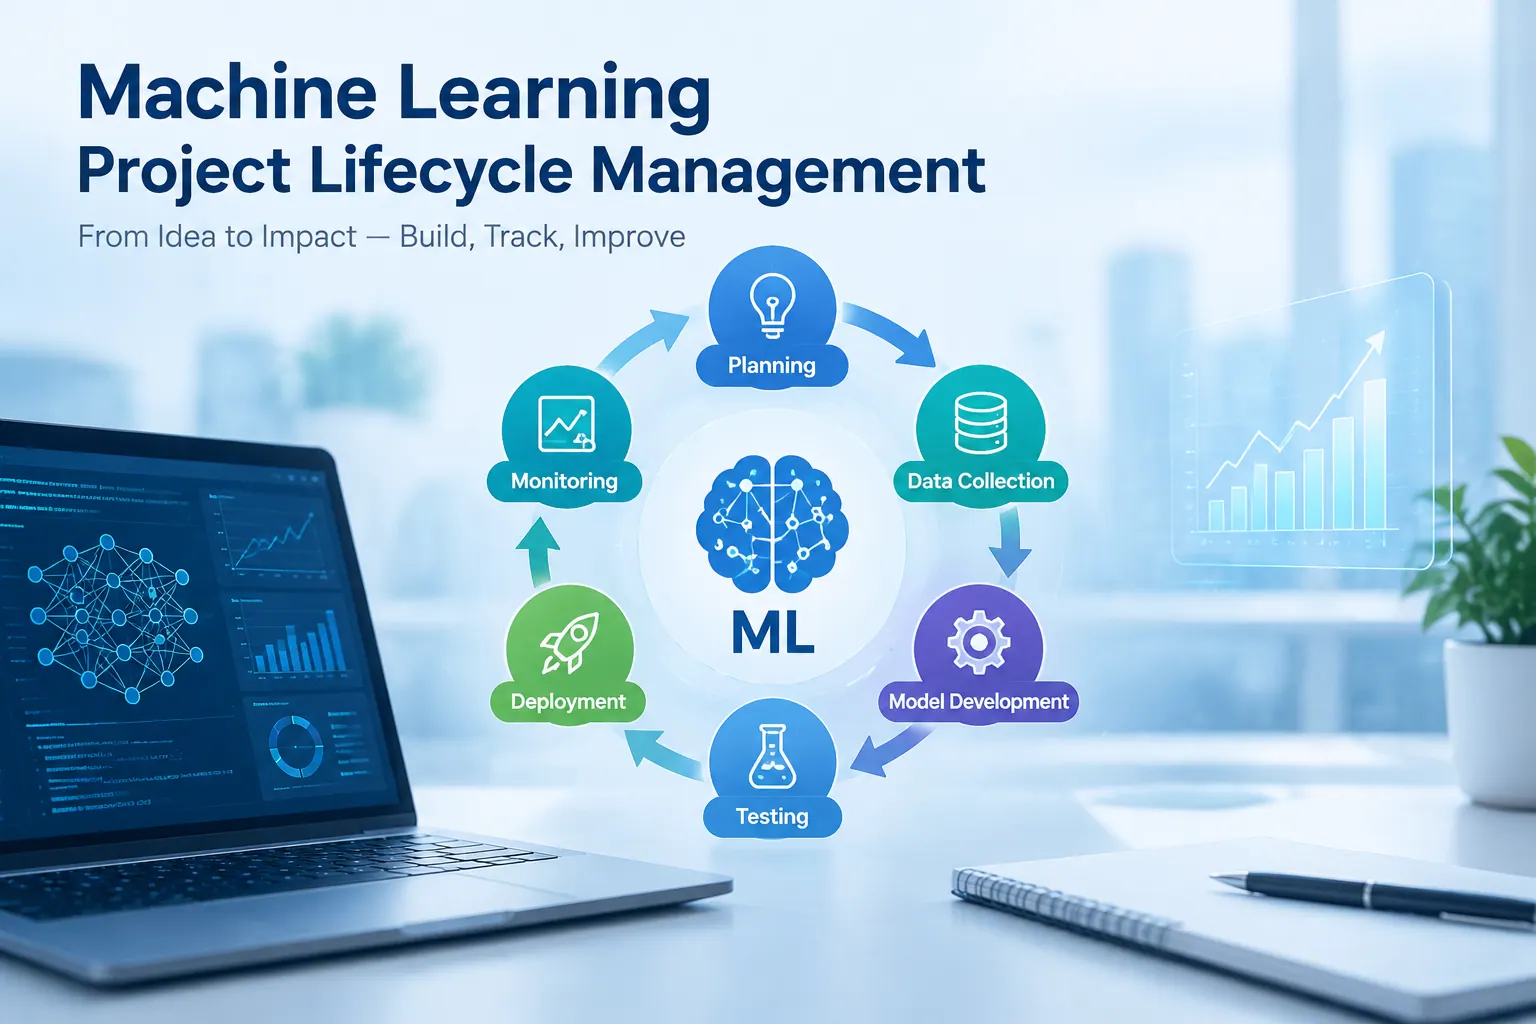
如何建立机器学习研发项目的生命周期管理机制
想让机器学习研发过程更可控,需要明确项目从需求提出到模型退役所经历的关键环节。
划分需求、开发、上线与运营阶段
可将生命周期划分为业务需求分析、数据准备、方案设计、模型开发、测试评估、上线部署、运行监控和迭代退役等阶段。每个阶段都应设定清晰的输入、输出、负责人和验收标准,避免项目只重视模型训练,却忽略上线后的维护与风险管理。
机器学习项目往往涉及产品、算法、数据、工程和业务团队,职责不清容易造成沟通成本增加和问题相互推诿。
建立跨职能协作与责任矩阵
可以使用责任分配矩阵明确产品经理、数据工程师、算法工程师、开发工程师、测试人员、运维人员和业务专家的职责。对数据合规、模型评审、上线审批、异常处理等关键事项,应明确执行人、审核人和决策人,并通过项目管理平台持续记录任务状态。
如果只根据模型准确率判断项目进展,可能忽略数据质量、业务价值、系统性能和合规要求。
采用技术、业务与风险相结合的评审指标
阶段评审可覆盖数据完整性、样本代表性、特征可解释性、模型效果、推理延迟、资源成本、业务转化率、稳定性和合规性等指标。每个阶段应设置通过门槛,例如数据质量未达标时不得进入模型训练,离线指标优秀但线上性能不足时不得直接发布。
数据集、特征代码、训练参数和模型文件发生变化时,如果缺少版本记录,问题定位和结果复现都会变得困难。
构建可追溯的版本管理体系
应对原始数据、清洗规则、特征工程代码、训练脚本、依赖环境、超参数、评估结果和模型文件进行统一编号与关联记录。通过数据版本管理、代码仓库、模型仓库和实验管理平台保存变更信息,使团队能够复现实验结果,并快速定位性能变化的原因。
模型部署并不代表项目结束,数据分布变化、业务规则调整和系统异常都可能导致模型效果下降。
覆盖系统、数据、效果与风险的持续监控
线上监控应包括接口可用性、响应时间、资源消耗、输入数据分布、特征缺失率、预测结果分布、模型准确率和业务指标。对于数据漂移、效果下降、异常预测或公平性风险,应设置告警阈值、升级路径和回滚方案,并定期开展模型复评与再训练。