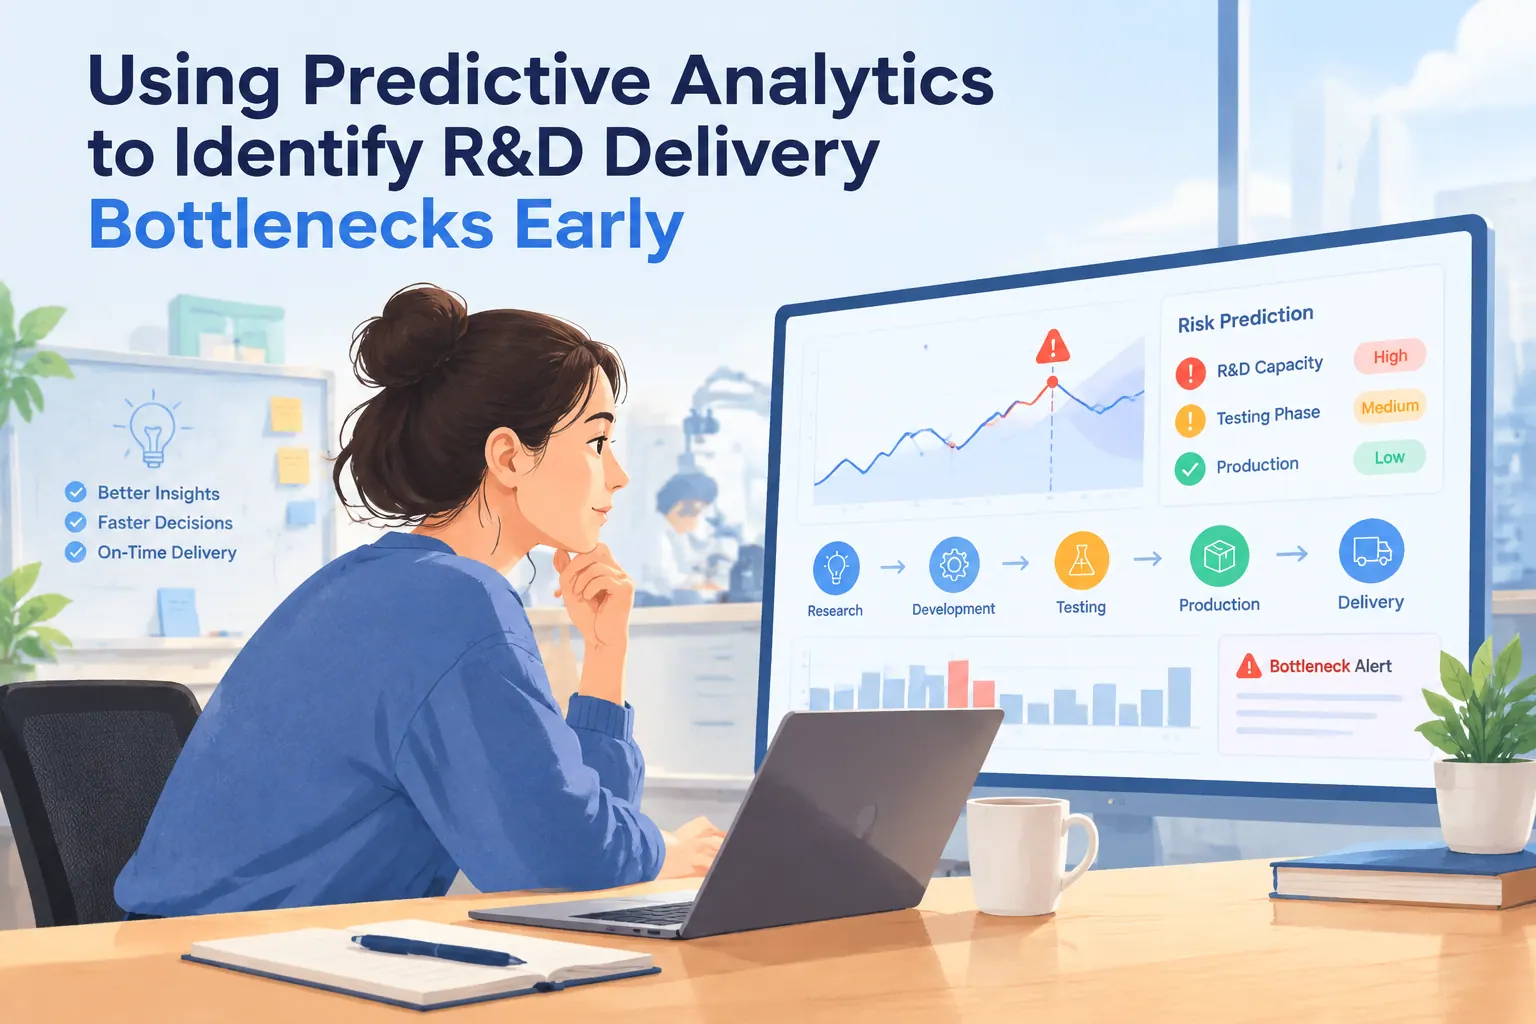
如何通过预测性分析提前识别研发交付瓶颈
常见问答
哪些研发数据适合用于预测交付风险?
团队想建立预测模型,需要采集哪些数据才能较准确地判断延期风险?
覆盖需求、开发、测试与资源数据
可重点采集需求变更频率、任务停留时长、代码提交量、缺陷密度、测试通过率、构建失败次数、人员负载和历史交付周期等数据。数据应保持统一口径并持续更新,避免因缺失、重复或统计标准不一致影响预测结果。
怎样判断某个环节已经出现潜在瓶颈?
项目还没有明显延期时,哪些指标能够提示研发流程正在形成阻塞?
关注周期异常与任务积压趋势
当任务平均停留时间持续增长、在制品数量快速上升、缺陷修复周期变长、代码评审排队增加或测试环境使用冲突频繁时,通常意味着相关环节存在潜在瓶颈。可结合历史基线设置动态阈值,对连续异常进行预警。
预测模型准确率不高时该如何优化?
系统频繁误报或漏报交付风险,团队应从哪些方面调整?
优化数据质量、特征与反馈机制
团队可检查样本数量、数据完整性和风险标签是否准确,并根据不同项目类型调整特征权重。模型输出还应与项目经理和技术负责人的实际判断进行比对,将真实交付结果回传,用于周期性校准和迭代。
小型研发团队有必要引入预测性分析吗?
团队规模较小、历史数据有限,是否也能利用预测方法识别交付风险?
可从轻量化规则和趋势分析入手
小型团队不必直接建设复杂模型,可以先基于迭代周期、任务逾期率、缺陷数量和成员负载设置预警规则。随着项目数据逐步积累,再引入回归分析、时间序列或机器学习模型,提高风险识别的精度。
发现高风险瓶颈后应该采取哪些措施?
预测系统提示测试或代码评审可能拖慢交付时,团队如何有效干预?
根据瓶颈类型配置针对性方案
团队可重新分配人员、限制并行任务数量、拆分高复杂度需求、提前准备测试环境,或增加自动化测试与评审资源。每项干预都应记录实施时间和效果,以便评估风险是否下降,并为后续预测积累可复用的数据。
* 文章含AI生成内容