如何用python六行代码爬取
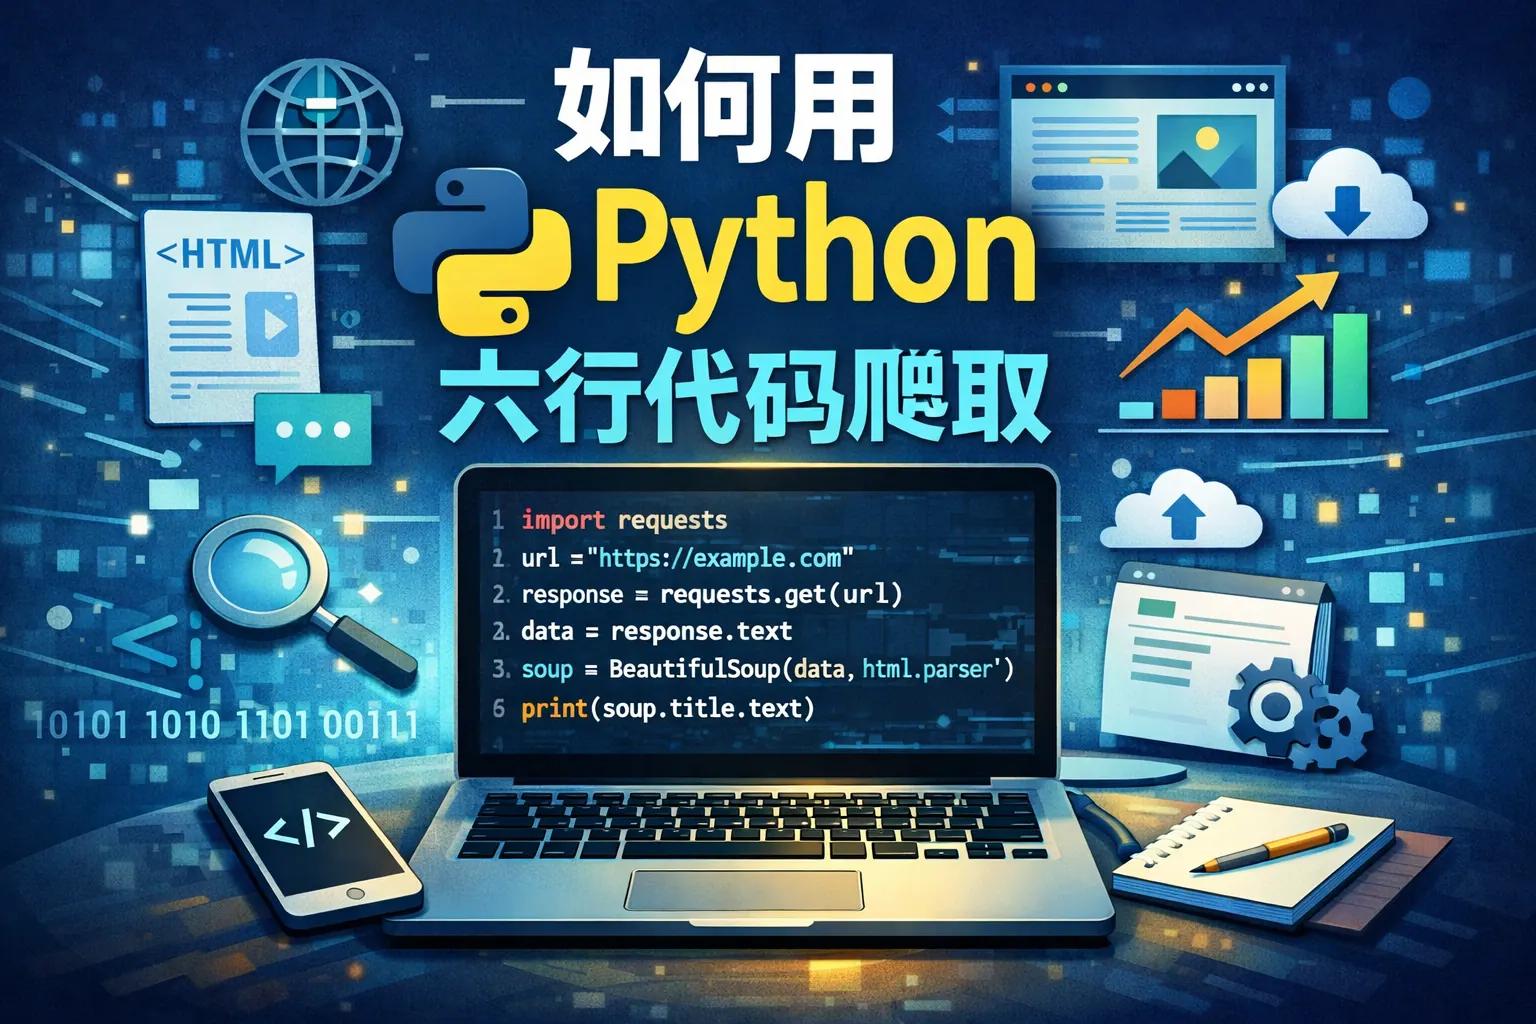
使用Python六行代码即可通过requests发送HTTP请求并结合BeautifulSoup解析HTML,实现基础静态网页数据抓取。这种方法适用于结构简单的页面,但面对动态渲染、反爬机制或大规模采集时需要更完整的技术方案与项目管理支持。理解请求原理、解析方式与合规边界,比单纯压缩代码行数更重要。随着数据合规加强和接口化趋势发展,网页抓取将向更规范与自动化方向演进。
常见问答
如何在最短时间内用Python实现基本网页数据爬取?
我想快速学会用Python爬取网页数据,有没有简单高效的方法?
使用requests和BeautifulSoup库快速爬取网页数据
利用requests库发送HTTP请求获取网页内容,再结合BeautifulSoup解析HTML结构,可以轻松实现网页数据爬取。整个过程简洁明了,适合快速入门。
用Python写爬虫时如何避免写太多代码?
写爬虫代码总是很长,有没有办法用少量代码完成爬取任务?
借助高效Python库编写精简爬虫程序
选择requests和BeautifulSoup等库能极大减少代码量,结合Python的简洁语法,通常只需几行代码即可实现基本的网页数据抓取。
使用Python爬取网页数据需要注意哪些常见问题?
写了小爬虫后,有时爬取失败或者数据错乱,应该怎么处理?
处理编码、反爬和数据解析问题以保证爬虫稳定
确保请求头部信息完整,正确处理网页编码,合理设定访问频率以防被封,同时使用合适的解析方法提取数据,都是保证爬虫正常运行的重要措施。
* 文章含AI生成内容
文章互动
这篇文章对你有帮助吗?