Python基于邻接表的prim算法
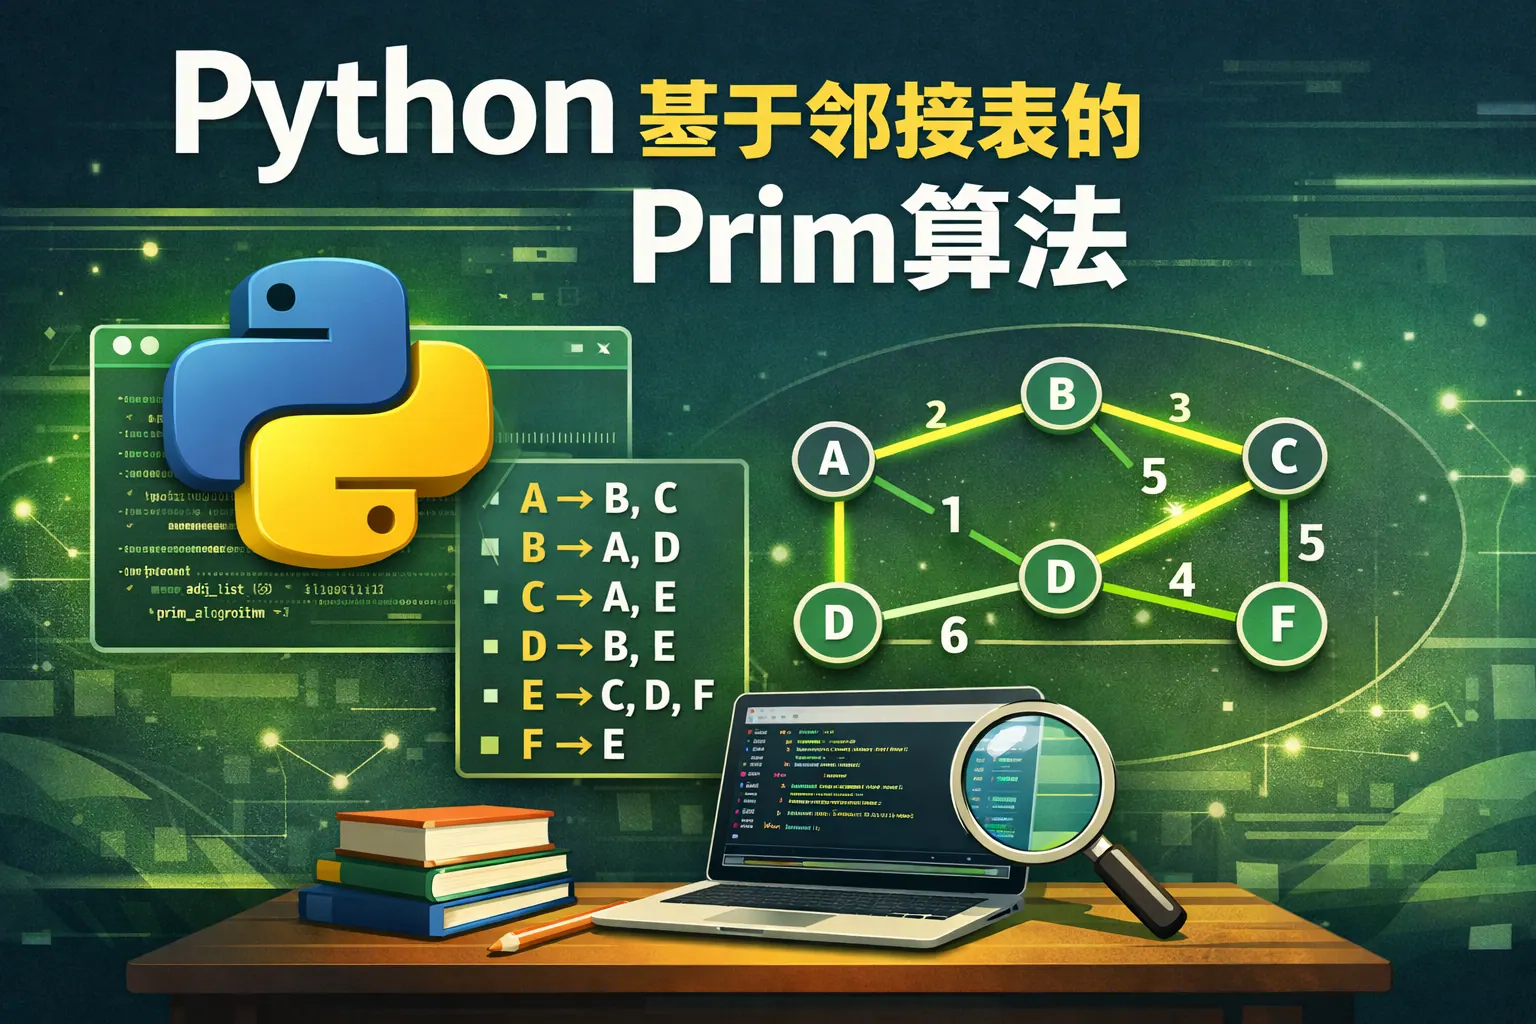
本文系统讲解了 Python 中基于邻接表实现的 Prim 算法,围绕最小生成树的核心概念、算法原理、数据结构设计与工程实现进行了深入分析。文章重点说明了邻接表在稀疏图中的空间与性能优势,并结合最小堆展示了高效的 Python 示例代码。同时对时间复杂度、常见问题以及与其他最小生成树算法的差异进行了对比说明。整体内容强调了该实现方案在实际项目中的稳定性、可维护性及长期应用价值。
常见问答
什么是邻接表在图算法中的作用?
在使用Prim算法时,为什么选择邻接表作为图的存储结构?邻接表相比其他数据结构有哪些优势?
邻接表在图算法中的优势
邻接表是一种以链表形式存储图中每个顶点相邻节点的结构。在实现Prim算法时,邻接表可以有效节省空间,特别适用于稀疏图。相比邻接矩阵,邻接表仅存储实际存在的边,从而降低了内存消耗和遍历时的时间复杂度。
如何在Python中实现基于邻接表的Prim算法?
在Python中使用邻接表结构实现Prim算法时,有哪些关键步骤和注意事项?需要借助哪些数据类型?
Python实现基于邻接表的Prim算法要点
实现过程中,首先需要使用字典或列表嵌套列表来构建邻接表。利用优先队列(heapq模块)来选择当前最小权重的边是关键。注意初始化权值数组,并确保每次更新邻接点的权重时保持最小值。遍历完所有顶点后,即可得到最小生成树。
Prim算法基于邻接表的时间复杂度是多少?
在使用邻接表实现Prim算法时,算法的时间复杂度表现如何?和使用邻接矩阵相比有哪些差异?
使用邻接表实现Prim算法的时间复杂度分析
基于邻接表与优先队列的Prim算法的时间复杂度通常为O(E log V),其中E是边的数量,V是顶点数量。邻接表结构使遍历操作更高效,特别适合稀疏图。而邻接矩阵实现通常为O(V^2),在顶点数量多且边较少时效率较低。
* 文章含AI生成内容
文章互动
这篇文章对你有帮助吗?