性能回归测试的指标对比分析方法
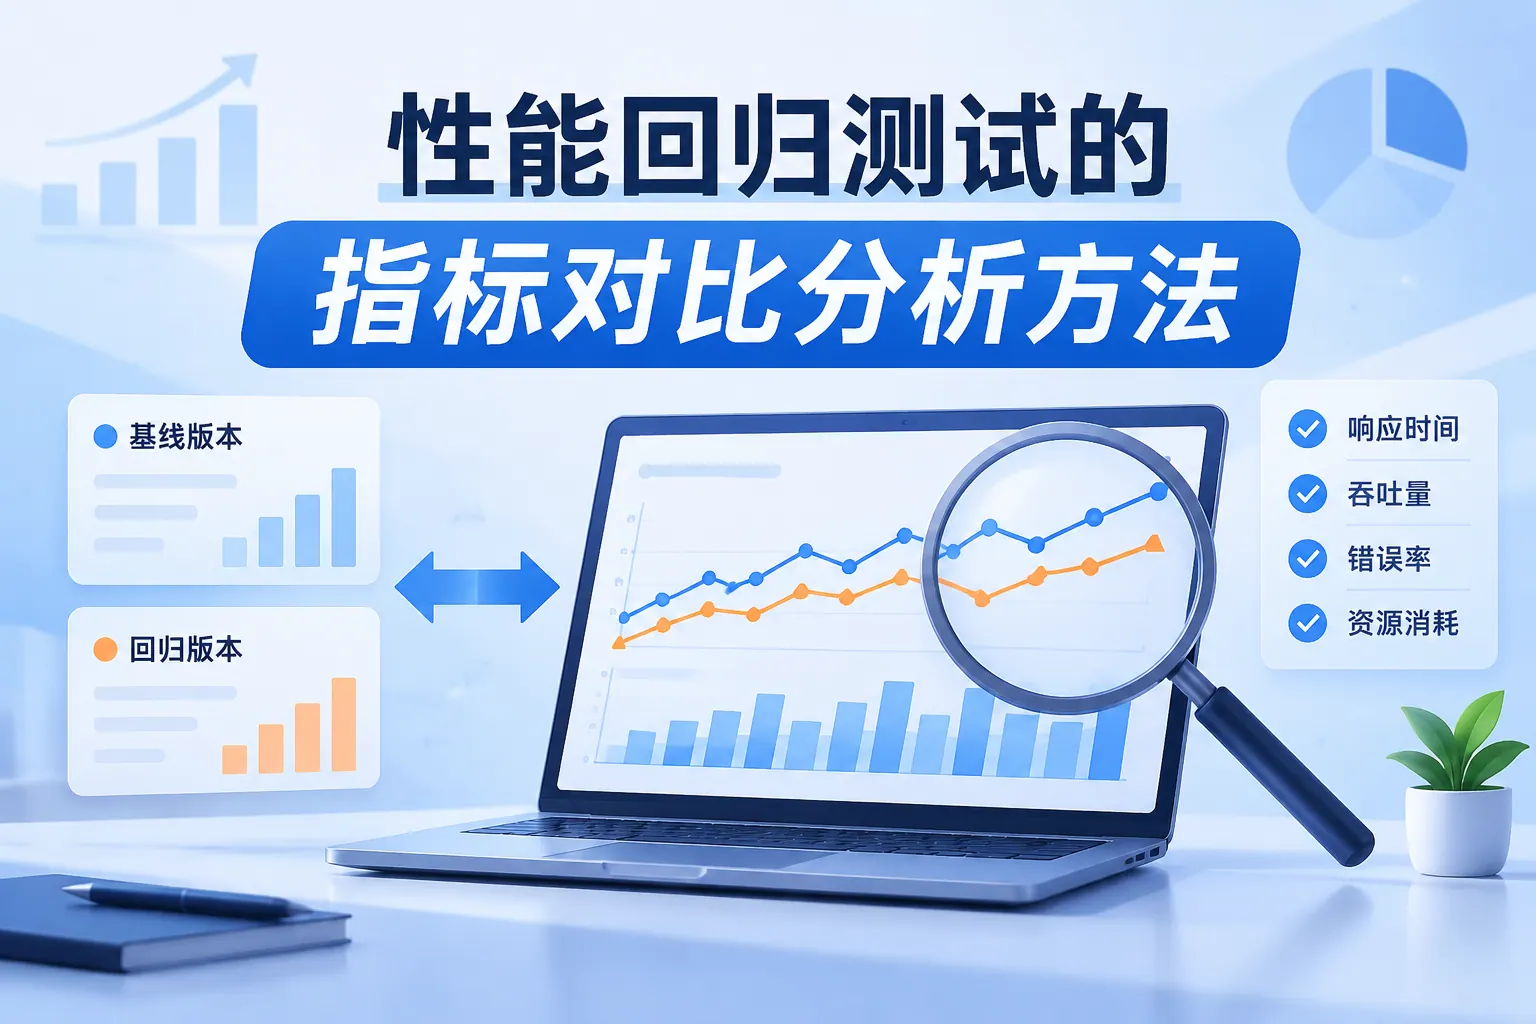
性能回归测试的指标对比分析,需要通过统一测试环境、负载模型和数据条件,建立可靠的历史性能基线,并重点比较平均响应时间、P95、P99、吞吐量、错误率、CPU、内存及数据库等指标。文章详细介绍了性能指标体系、相对变化率计算、多轮测试分析、资源关联排查、常见误判及解决方法,并说明如何通过测试报告、缺陷追踪和发布门禁建立持续改进机制,帮助研发团队准确识别性能退化,降低版本迭代带来的性能风险。
如何判断一次版本迭代是否引发了系统性能变化?
重点关注响应、吞吐与资源指标
可从响应时间、吞吐量、并发用户数、错误率、CPU使用率、内存占用、磁盘I/O和网络流量等维度进行观察。响应时间反映用户体验,吞吐量体现系统处理能力,错误率用于判断稳定性,资源指标则有助于定位性能瓶颈。
不同测试结果之间如何保证具有可比性?
建立稳定且条件一致的基线
基线可以选择上一个稳定版本、正式环境历史峰值,或经过验证的标准版本。对比时应保持硬件配置、操作系统、数据库数据量、网络条件、测试脚本、并发模型和运行时长一致,避免环境差异干扰结论。
测试数据出现波动时,怎样区分正常误差与真实问题?
结合阈值、趋势和统计结果判断
可设置明确的性能门槛,例如响应时间增长超过10%、吞吐量下降超过5%或错误率超出既定范围。同时建议执行多轮测试,使用平均值、P95、P99、标准差和置信区间进行分析。持续、多轮且超过阈值的变化,更可能属于真实回归。
为什么不能只比较平均响应时间?
高分位延迟能揭示少数慢请求
平均响应时间容易掩盖长尾请求。P95表示95%的请求响应时间不超过该数值,P99则能反映更极端的延迟情况。对于支付、搜索、接口网关等场景,应结合平均值、P95、P99和最大值分析,避免少量严重慢请求被平均值掩盖。
发现响应时间变差后,应从哪些方向排查?
通过分层指标缩小问题范围
可以按照请求链路拆分分析应用、数据库、缓存、消息队列和外部服务。若CPU升高,可检查计算逻辑与线程使用;若内存持续增长,可排查对象泄漏和缓存策略;若数据库耗时增加,可查看执行计划、索引和锁等待;若吞吐下降,则需关注线程池、连接池和限流配置。