linux脚本sleep如何用
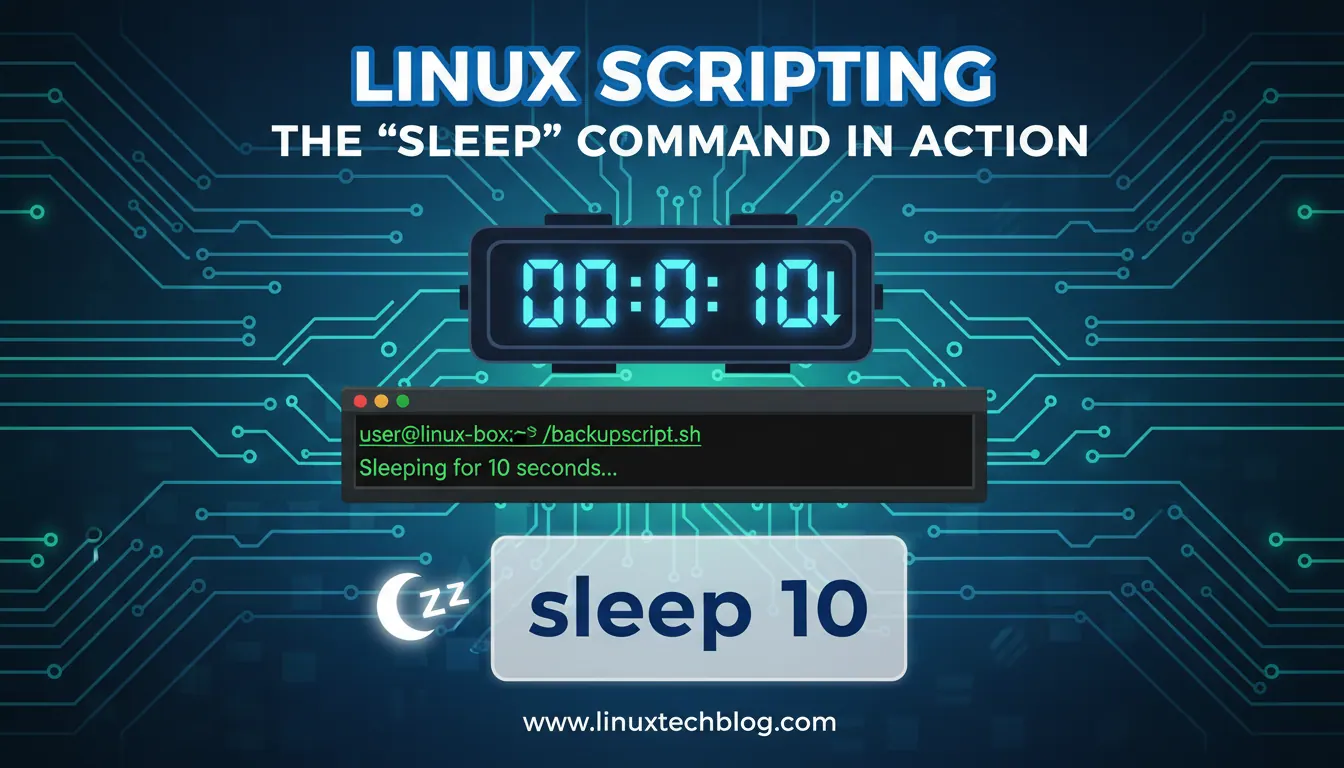
文章围绕 Linux 脚本中 sleep 的用法展开,先直接给出结论:sleep 用于让脚本暂停指定时间,常见写法有按秒、分钟、小时和小数秒暂停,但真正关键不只是语法,而是如何在脚本中合理使用。正文先讲了 sleep 的基础用法,包括 sleep 5、sleep 2m、sleep 1h、sleep 0.5 以及结合变量控制等待时长;接着说明它适合的几类场景,如命令之间的缓冲、循环轮询时控制频率、失败重试之间的间隔、批处理中的节流限速。文章重点强调了常见误区:不能把 sleep 当成状态判断,固定等待不等于目标已经就绪,等待过长会拖慢脚本,复杂依赖也不能靠单次 sleep 解决。随后给出更稳的实践方法,包括采用“检测一次再暂停一次”的结构、设置最大等待上限、按不同场景拆分等待参数、在日志中写清等待原因。最后用 4 类典型思路总结 sleep 的实战用法:纯延时、轮询等待、重试退避和节流限速,帮助读者理解 sleep 不只是暂停命令,而是脚本执行节奏控制的一部分。
我想在 Shell 脚本中加入等待时间,但不清楚 sleep 一般适合用在什么地方,能举一些实际场景吗?
sleep 的常见使用场景
sleep 常用于控制脚本执行节奏,例如在循环中间隔执行任务、等待某个服务启动完成、给接口调用增加重试间隔、延迟触发定时动作。它适合处理“需要暂停一段时间再继续执行”的场景。
如果我想让脚本暂停 0.5 秒或 1.2 秒,Linux 里的 sleep 是否支持这种写法?
sleep 支持小数秒
大多数 Linux 环境下,sleep 可以接受小数参数,例如 sleep 0.5 表示暂停半秒,sleep 1.2 表示暂停 1.2 秒。具体是否支持取决于系统自带的 sleep 版本,常见的 GNU coreutils 通常支持。
我想让脚本每隔一段时间检查一次文件或接口状态,不想一直占用资源,应该怎么结合 sleep 来写?
用 sleep 控制轮询间隔
可以在循环体内加入 sleep 来控制检查频率,例如每隔 5 秒执行一次状态查询。这样能避免脚本持续高频运行,减少系统和接口压力。通常会把 sleep 放在每次检查之后,让脚本按固定间隔重复执行。
我担心写了 sleep 以后脚本会一直等待,影响整体流程,有没有办法让等待更可控?
通过合理设置等待时长来控制影响
sleep 本身就是阻塞等待,所以关键在于设置合适的时长,并结合条件判断使用。例如只在资源未就绪时等待,或限制重试次数,避免无限等待。若需要更灵活的控制,可以配合后台任务、超时命令或循环判断一起设计。